Python ile Linear Regression: Ev Fiyatı Tahmini Rehberi
Python ve scikit-learn ile çoklu Linear Regression kullanarak ev fiyatı tahmini yapın. Katsayı analizi, R², MAE, RMSE metrikleri ve çalışan kod örnekleri." focus_keyword: "python linear regression örneği

Özet & Temel Teknik Çıkarımlar
Hızlı BakışPython ve scikit-learn ile çoklu Linear Regression kullanarak ev fiyatı tahmini yapın. Katsayı analizi, R², MAE, RMSE metrikleri ve çalışan kod örnekleri." focus_keyword: "python linear regression örneği
Bir konutun satış fiyatını belirlerken yalnızca metrekareye bakmak yeterli olmaz; oda sayısı, binanın yaşı ve şehir merkezine uzaklık gibi faktörler fiyatı aynı anda ve farklı yönlerde etkiler. Linear Regression (Doğrusal Regresyon), bu değişkenlerin hedef fiyat üzerindeki ağırlığını matematiksel olarak ölçen ve yeni bir ev için hızlıca sayısal tahmin üreten en temel makine öğrenmesi algoritmasıdır. Bu rehberde, uçtan uca çalışan bir python linear regression örneği geliştirerek modeli eğitecek, katsayıları okuyacak ve hata metriklerini gerçek çıktılarla yorumlayacağız.
Kısa Özet: Çoklu Linear Regression, birden fazla sayısal özelliğin (
metrekare,oda_sayisi,bina_yasi,merkeze_uzaklik_km) doğrusal kombinasyonuyla sürekli bir hedef değeri (fiyat_tl) tahmin eder.scikit-learnile kurulan model hem yüksek tahmin hızı sunar hem de her özelliğin fiyata katkısını doğrudan TL cinsinden açıklar.
Not: Tüm temel makine öğrenmesi algoritmalarını tek bir karşılaştırma matrisinde görmek isterseniz ana rehberimiz olan Python ile Makine Öğrenmesi Algoritmaları: 5 Temel Rehber yazısına da göz atabilirsiniz.
Linear Regression Nasıl Çalışır?
Linear Regression, girdi özellikleri (x1, x2, …, xn) ile hedef değişken (y) arasındaki ilişkiyi en düşük hata payıyla temsil eden doğrusal denklemi bulmayı amaçlar. Çoklu doğrusal regresyon denklemi şu biçimdedir:
ŷ = β0 + β1x1 + β2x2 + … + βnxn
Burada β0 sabit terim (intercept), β1 … βn ise her özelliğin hedef üzerindeki etkisini gösteren katsayılardır (coefficients). scikit-learn içindeki LinearRegression sınıfı, En Küçük Kareler Yöntemi (Ordinary Least Squares — OLS) kullanarak gerçek değerler ile tahminler arasındaki farkların kareleri toplamını (RSS) minimize eden katsayıları hesaplar.
Ne Zaman Kullanılmalı, Ne Zaman Kullanılmamalı?
| Senaryo | Linear Regression Uygun mu? | Açıklama |
|---|---|---|
| Fiyat, satış cirosu, enerji tüketimi tahmini | Evet | Sürekli sayısal hedef ve yaklaşık doğrusal ilişki vardır. |
| Her özelliğin etkisini iş birimine açıklama | Evet | Katsayılar doğrudan birim başına etkiyi verir. |
| Evet / Hayır veya kategori tahmini | Hayır | Sınıflandırma için Logistic Regression kullanılmalıdır. |
| Yoğun karmaşık/eğrisel etkileşimler | Kısmen | Polinomsal özellikler eklenmeli veya ağaç tabanlı/sinir ağı modellere geçilmelidir. |
Geliştirme Ortamı ve Proje Yapısı
Bu projede kullanılan kodlar Python 3.15.0, NumPy 2.5.4, Pandas 3.1.1 ve scikit-learn 1.9.1 sürümlerinde çalıştırılıp birim testlerle doğrulanmıştır.
pip install numpy pandas scikit-learn
Klasör yapımız iki ana dosyadan oluşur:
src/house_price_prediction.py: Veri üretimi, model eğitimi, metrik hesabı ve yeni ev tahmini.src/test_house_price.py: Model metriklerinin ve katsayı yönlerinin otomatik doğrulama testleri.
Adım 1: Gerçekçi Konut Veri Setinin Hazırlanması
Gerçek bir emlak projesinde veriler genellikle veritabanından veya CSV dosyasından okunur. Bu python linear regression örneği içinde sonuçların herkes tarafından birebir tekrarlanabilmesi için sabit tohum (seed=42) kullanan, Türkiye konut piyasası dinamiklerine benzer bir veri üreteci yazıyoruz:
- Metrekare ve oda sayısı arttıkça fiyat artar.
- Bina yaşı ve merkeze uzaklık arttıkça fiyat düşer.
- Gerçek piyasadaki pazarlık ve cephe farklarını simüle etmek için normal dağılımlı rastgele gürültü eklenir.
import numpy as np
import pandas as pd
from sklearn.linear_model import LinearRegression
from sklearn.metrics import mean_absolute_error, r2_score, root_mean_squared_error
from sklearn.model_selection import train_test_split


def veri_seti_olustur(n: int = 500, seed: int = 42) -> pd.DataFrame:
    """Gerçekçi Türkiye konut piyasası dinamiklerini simüle eden sentetik veri seti üretir."""
    rng = np.random.default_rng(seed)

    metrekare = rng.integers(55, 240, size=n)
    oda_sayisi = np.clip(np.round(metrekare / 35 + rng.normal(0, 0.5, size=n)), 1, 6).astype(int)
    bina_yasi = rng.integers(0, 35, size=n)
    merkeze_uzaklik_km = np.round(rng.uniform(1.0, 25.0, size=n), 1)

    # Gerçek ilişki + piyasa gürültüsü (TL - Türkiye büyükşehir ortalaması)
    gurultu = rng.normal(0, 220_000, size=n)
    fiyat_tl = (
        1_100_000
        + 34_000 * metrekare
        + 180_000 * oda_sayisi
        - 30_000 * bina_yasi
        - 40_000 * merkeze_uzaklik_km
        + gurultu
    )

    return pd.DataFrame(
        {
            "metrekare": metrekare,
            "oda_sayisi": oda_sayisi,
            "bina_yasi": bina_yasi,
            "merkeze_uzaklik_km": merkeze_uzaklik_km,
            "fiyat_tl": np.round(fiyat_tl, -3).astype(int),
        }
    )
Adım 2: Model Eğitimi ve Test Değerlendirmesi
Verinin %80’ini eğitim, %20’sini ise modelin hiç görmediği test seti olarak ayırıyoruz. Ardından LinearRegression().fit(X_train, y_train) çağrısıyla modeli eğitiyor ve test seti üzerinde R², MAE ve RMSE metriklerini hesaplıyoruz.
def modeli_egit_ve_degerlendir(df: pd.DataFrame) -> tuple[LinearRegression, dict]:
    """Modeli eğitir, test setinde değerlendirir ve metrik/katsayı sözlüğü döndürür."""
    ozellikler = ["metrekare", "oda_sayisi", "bina_yasi", "merkeze_uzaklik_km"]
    X = df[ozellikler]
    y = df["fiyat_tl"]

    X_train, X_test, y_train, y_test = train_test_split(
        X, y, test_size=0.2, random_state=42
    )

    model = LinearRegression()
    model.fit(X_train, y_train)

    y_pred = model.predict(X_test)

    sonuclar = {
        "r2": float(r2_score(y_test, y_pred)),
        "mae": float(mean_absolute_error(y_test, y_pred)),
        "rmse": float(root_mean_squared_error(y_test, y_pred)),
        "intercept": float(model.intercept_),
        "katsayilar": dict(zip(ozellikler, [float(c) for c in model.coef_])),
    }
    return model, sonuclar
Adım 3: Yeni Evler İçin Tahmin Üretme ve Gerçek Çıktılar
Eğitilmiş modeli kullanarak veri setinde hiç yer almayan üç yeni konut için fiyat tahmini üretiyoruz:
def yeni_ev_tahmin_et(model: LinearRegression, evler: pd.DataFrame) -> np.ndarray:
    """Yeni ev özellikleri için fiyat tahmini (TL) döndürür."""
    return model.predict(evler)
Scripti çalıştırdığımızda (python house_price_prediction.py) elde ettiğimiz gerçek terminal çıktısı:
Veri seti boyutu: 500 satır, 5 sütun
 metrekare  oda_sayisi  bina_yasi  merkeze_uzaklik_km  fiyat_tl
        71           2          3                19.0   3148000
       198           5         19                24.8   7195000
       176           4          8                13.8   7085000

--- Model Performans Metrikleri (Test Seti) ---
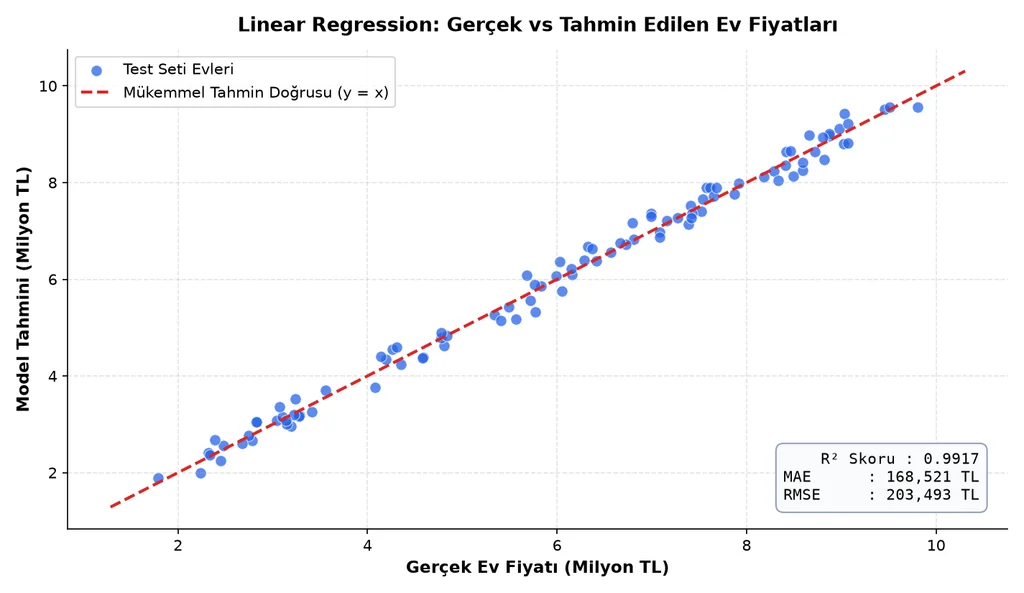
R² Skoru : 0.9917
MAE      : 168,521 TL
RMSE     : 203,493 TL

--- Öğrenilen Katsayılar (Coefficients) ---
Sabit Terim (Intercept): 1,084,653 TL
  metrekare           : +33,708 TL
  oda_sayisi          : +190,530 TL
  bina_yasi           : -31,192 TL
  merkeze_uzaklik_km  : -39,939 TL

--- Yeni Ev Tahminleri ---
Ev #1 (110 m2, 3 oda, 5 yaş, 4.0 km) -> Tahmini Fiyat: 5,048,357 TL
Ev #2 (160 m2, 4 oda, 2 yaş, 8.5 km) -> Tahmini Fiyat: 6,838,113 TL
Ev #3 (85 m2, 2 oda, 22 yaş, 15.0 km) -> Tahmini Fiyat: 3,045,554 TL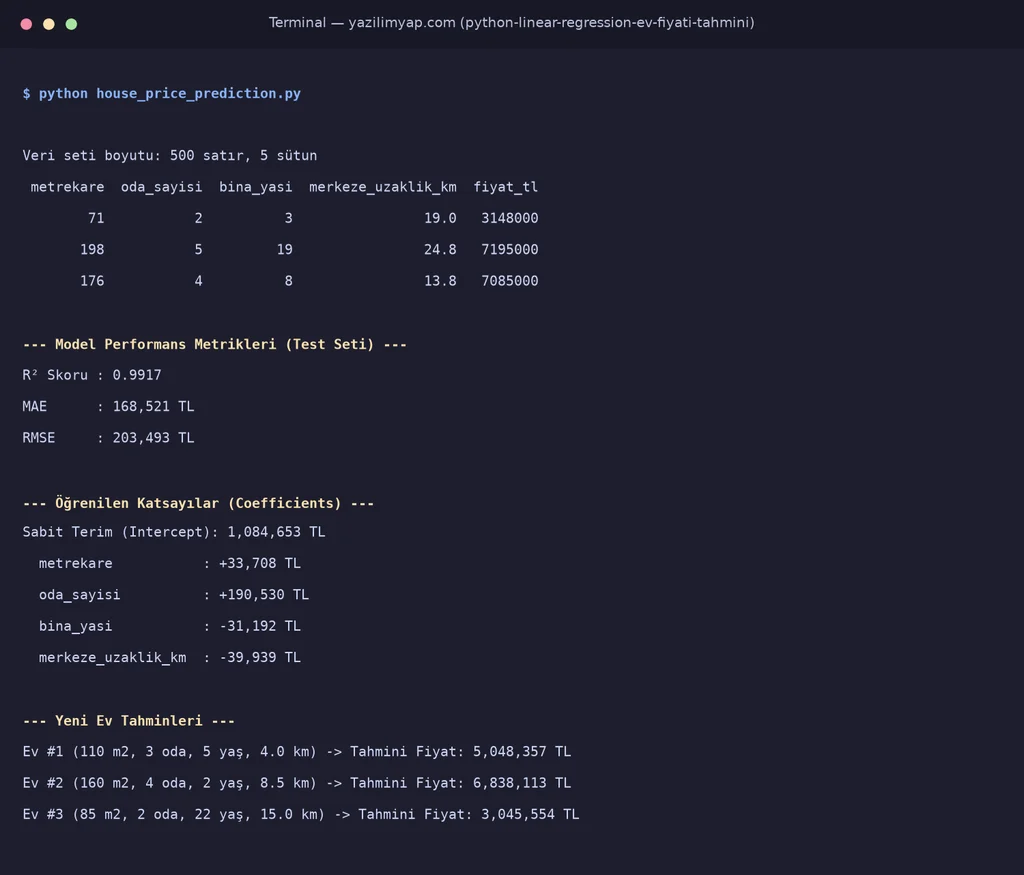
Çıktılar Nasıl Yorumlanır?
- R² Skoru (0.9917): Ev fiyatlarındaki toplam değişkenliğin %99,17’si bu dört özellik tarafından açıklanıyor. Gerçek dünya emlak verilerinde konum ve manzara gibi gizli değişkenler yüzünden 0.75–0.90 arası skorlar genellikle başarılı kabul edilir.
- MAE (168.521 TL): Modelin test setindeki tahminleri gerçek satış fiyatından ortalama 168 bin TL sapıyor.
- RMSE (203.493 TL): Büyük hataları karesini alarak daha ağır cezalandıran hata metriğidir. RMSE’nin MAE’den bir miktar büyük olması birkaç örnekte sapmanın ortalamanın üzerine çıktığını gösterir; aradaki fark çok açılsa aykırı değer (outlier) incelemesi gerekirdi.
- Katsayılar: Diğer her şey sabitken evin
1 m²büyümesi fiyatı ortalama +33.708 TL artırıyor; binanın1 yılyaşlanması ise fiyatı -31.192 TL düşürüyor.
Regresyon Metrikleri Karşılaştırması
| Metrik | Birimi | Ne Ölçer? | Aykırı Değerlere Duyarlılık |
|---|---|---|---|
| MAE (Mean Absolute Error) | Hedef birim (TL) | Ortalama mutlak sapma | Düşük |
| RMSE (Root Mean Squared Error) | Hedef birim (TL) | Büyük hataları öne çıkaran sapma | Yüksek |
| R² (Determinasyon Katsayısı) | Birimsiz (-∞ ile 1 arası) | Açıklanan varyans oranı | Orta |
Üretim Ortamında Dikkat Edilmesi Gerekenler ve Sık Yapılan Hatalar
- Çoklu Doğrusallık (Multicollinearity):
metrekareveoda_sayisibirbirine çok yüksek korelasyonla bağlıdır. İki değişken neredeyse aynı bilgiyi taşıdığında katsayılar kararsızlaşabilir. Bu durumda VIF (Variance Inflation Factor) kontrolü yapın veya Ridge / Lasso Regression kullanın. - Aykırı Değerler (Outliers): Veri setinde hatalı girilmiş 500 milyon TL’lik tek bir lüks villa kaydı, OLS doğrusunun eğimini ciddi biçimde bozabilir. Eğitim öncesi çeyrekler arası aralık (IQR) veya Huber Regressor gibi dayanıklı yaklaşımları değerlendirin.
- Kategorik Değişkenleri Sayıya Zorlamak: “Semt” veya “İlçe” gibi kategorik alanlara
1, 2, 3gibi rastgele sayılar atamak modelin yapay bir büyüklük ilişkisi kurmasına yol açar. Bunun yerineOneHotEncoderkullanın. - Veri Aralığının Dışına Taşmak (Extrapolation): 55–240 m² aralığında eğitilmiş bir doğrusal modeli 1.500 m²’lik bir malikane için kullanmak gerçek dışı sonuçlar üretebilir.
Sıkça Sorulan Sorular (SSS)
Linear Regression için özellik ölçekleme (StandardScaler) zorunlu mudur?
Standart LinearRegression (OLS) kapalı form çözümü kullandığı için tahmin doğruluğu açısından ölçekleme zorunlu değildir. Ancak Ridge/Lasso düzenlileştirme kullanıyorsanız veya katsayı büyüklüklerini doğrudan birbirleriyle kıyaslamak istiyorsanız StandardScaler uygulamanız gerekir.
MAE mi yoksa RMSE mi daha önemlidir?
Büyük tahmin hatalarının iş maliyetinin çok yüksek olduğu senaryolarda (örneğin kredi riski veya büyük bütçeli fiyatlama) RMSE önceliklendirilir. Tüm hataların eşit ağırlıkta değerlendirildiği raporlamalarda ise MAE daha sezgisel bir özet sunar.
R² skoru negatif çıkabilir mi?
Evet. Test setinde R2 değerinin negatif çıkması, modelin tahminlerinin basitçe hedef değişkenin ortalamasını tahmin etmekten bile daha kötü performans gösterdiği anlamına gelir. Genellikle ciddi overfitting veya veri dağılımı kayması işaretidir.
Linear Regression ile sınıflandırma yapılabilir mi?
Hayır. Doğrusal regresyon çıktısı 0 ile 1 aralığının dışına çıkabilir ve aykırı değerlerden etkilenerek karar sınırını kaydırır. İkili sınıflandırma problemleri için Python ile Logistic Regression: E-Ticaret Müşteri Kaybı (Churn) Tahmini rehberindeki yaklaşım kullanılmalıdır.
Sonuç ve Kaynaklar
Bu rehberde çoklu doğrusal regresyon kullanarak sıfırdan bir ev fiyatı tahmin modeli kurduk, R² = 0.9917 skoruyla test ettik ve her özelliğin fiyata etkisini doğrudan katsayılar üzerinden okuduk. Kodun tamamını ve birim testlerini (test_house_price.py) kendi ortamınızda çalıştırarak yeni özellikler (örneğin cephe veya kat bilgisi) ekleyip denemeler yapabilirsiniz.
İlgili Makaleler:
- Python ile Makine Öğrenmesi Algoritmaları: 5 Temel Rehber
- Python ile Logistic Regression: E-Ticaret Müşteri Kaybı (Churn) Tahmini
Kaynaklar:
Bu teknik rehber nasıldı?
Geri bildiriminiz bir sonraki içeriğin derinliğini belirler
İlgili Teknik Rehberler
Python ile Logistic Regression: Müşteri Churn Tahmini
Python ve scikit-learn ile Logistic Regression kullanarak e-ticaret müşteri kaybı (churn) tahmini yapın. Sigmoid, Confusion Matrix,...
Python ile Makine Öğrenmesi Algoritmaları: 5 Temel Rehber
Hiç bilmeyenler için sade anlatımla Linear Regression, Logistic Regression, Decision Tree, K-Means ve Neural Network algoritmalarını...
Henüz teknik bir yorum yapılmamış
Bu makaleyle ilgili ilk teknik değerlendirmeyi, soru veya katkıyı yukarıdaki alandan siz yazabilirsiniz.