Python ile Logistic Regression: Müşteri Churn Tahmini
Python ve scikit-learn ile Logistic Regression kullanarak e-ticaret müşteri kaybı (churn) tahmini yapın. Sigmoid, Confusion Matrix, ROC-AUC ve eşik analizi.

Özet & Temel Teknik Çıkarımlar
Hızlı BakışPython ve scikit-learn ile Logistic Regression kullanarak e-ticaret müşteri kaybı (churn) tahmini yapın. Sigmoid, Confusion Matrix, ROC-AUC ve eşik analizi.
Yeni bir müşteri kazanmanın maliyeti, mevcut bir müşteriyi elde tutma maliyetinin genellikle 5 ila 7 katıdır. Bu nedenle e-ticaret ve SaaS şirketleri, aboneliğini iptal etmek üzere olan kullanıcıları önceden tespit eden müşteri kaybı (churn) tahmin modelleri kullanır. Bu rehberde, gerçekçi bir python logistic regression örneği kurarak müşteri davranışlarından ayrılma olasılığı hesaplayacak, StandardScaler + LogisticRegression hattını (Pipeline) test edecek ve iş hedeflerine göre karar eşiğini (threshold) nasıl ayarlayacağınızı göreceğiz.
Kısa Özet: Logistic Regression, sürekli özelliklerden yola çıkarak bir olayın gerçekleşme olasılığını (
0ile1arasında) tahmin eden bir ikili sınıflandırma algoritmasıdır. Sigmoid fonksiyonu,class_weight="balanced"ve doğru karar eşiği seçimiyle dengesiz churn verilerinde yüksek yakalama oranı (Recall) elde edilebilir.
Not: Beş temel makine öğrenmesi algoritmasını bir arada karşılaştırmak için Python ile Makine Öğrenmesi Algoritmaları: 5 Temel Rehber yazımıza, sayısal değer tahmini içinse Python ile Linear Regression: Ev Fiyatı Tahmini Rehberi makalemize göz atabilirsiniz.
Logistic Regression Nasıl Çalışır? Sigmoid Fonksiyonu
Linear Regression çıktı olarak eksi sonsuz ile artı sonsuz arasında herhangi bir sayı üretebilir. Oysa bir müşterinin ayrılma olasılığı mutlaka %0 ile %100 (0 ile 1) arasında olmalıdır. Logistic Regression, özelliklerin doğrusal kombinasyonunu (z = β0 + β1x1 + … + βnxn) Sigmoid (Lojistik) fonksiyonundan geçirerek bu sınırı garanti eder:
P(y = 1 | x) = σ(z) = 1 / (1 + e−z)
Model varsayılan olarak P ≥ 0.50 ise müşteriyi Ayrılacak (1), değilse Kalacak (0) olarak sınıflandırır. Ancak iş problemine göre bu eşik değeri 0.35 veya 0.70 gibi farklı bir noktaya çekilebilir.
Linear Regression ve Logistic Regression Karşılaştırması
| Özellik | Linear Regression | Logistic Regression |
|---|---|---|
| Çıktı Tipi | Sürekli sayısal değer (ör. 5.048.357 TL) | 0–1 arası olasılık ve sınıf etiketi (0 / 1) |
| Aktivasyon / Dönüşüm | Yok (Doğrusal kombinasyon) | Sigmoid (veya çok sınıfta Softmax) |
| Kayıp Fonksiyonu | Mean Squared Error (MSE) | Log-Loss (Binary Cross-Entropy) |
| Temel Metrikler | R2, MAE, RMSE | Accuracy, Precision, Recall, F1-Score, ROC-AUC |
| Örnek Kullanım | Ev fiyatı, satış tahmini | Churn tahmini, fraud tespiti, spam filtresi |
Geliştirme Ortamı ve Proje Yapısı
Tüm kodlar Python 3.15.0, NumPy 2.5.4, Pandas 3.1.1 ve scikit-learn 1.9.1 sürümlerinde çalıştırılıp birim testlerle doğrulanmıştır.
pip install numpy pandas scikit-learn
Proje klasöründe iki dosya yer alır:
src/churn_prediction.py: Müşteri veri üreteci,Pipelineeğitimi, metrik/eşik analizi ve risk tahmini.src/test_churn.py: Model kalitesi, eşik davranışı ve risk sıralaması için otomatik doğrulama testleri.
Adım 1: E-Ticaret Müşteri Veri Setinin Oluşturulması
Bu python logistic regression örneği için 800 müşterilik, tekrarlanabilir (seed=42) bir davranış veri seti oluşturuyoruz. Senaryomuz gerçek e-ticaret dinamiklerini yansıtır:
- Aylık giriş sayısı (
aylik_giris_sayisi) ve üyelik süresi (uyelik_suresi_ay) arttıkça ayrılma riski azalır. - Destek talebi sayısı (
destek_talebi_sayisi) arttıkça memnuniyetsizlik ve churn olasılığı yükselir. - Yüksek aylık harcama (
aylik_harcama_tl) platforma bağlılığı gösterir.
import numpy as np
import pandas as pd
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import (
    accuracy_score,
    classification_report,
    confusion_matrix,
    precision_score,
    recall_score,
    roc_auc_score,
)
from sklearn.model_selection import train_test_split
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler


def churn_verisi_olustur(n: int = 800, seed: int = 42) -> pd.DataFrame:
    """Abonelik / e-ticaret müşteri davranışlarını simüle eden gerçekçi veri seti üretir."""
    rng = np.random.default_rng(seed)

    aylik_giris_sayisi = rng.integers(1, 45, size=n)
    destek_talebi_sayisi = rng.integers(0, 9, size=n)
    uyelik_suresi_ay = rng.integers(1, 48, size=n)
    aylik_harcama_tl = np.round(rng.uniform(150.0, 4500.0, size=n), 2)

    # Sigmoid olasılık modeli: az giriş + çok destek talebi + kısa üyelik -> yüksek churn riski
    logit = (
        0.55
        - 0.095 * aylik_giris_sayisi
        + 0.58 * destek_talebi_sayisi
        - 0.045 * uyelik_suresi_ay
        - 0.00035 * aylik_harcama_tl
    )
    olasilik = 1.0 / (1.0 + np.exp(-logit))
    churn = (rng.random(n) < olasilik).astype(int)

    return pd.DataFrame(
        {
            "aylik_giris_sayisi": aylik_giris_sayisi,
            "destek_talebi_sayisi": destek_talebi_sayisi,
            "uyelik_suresi_ay": uyelik_suresi_ay,
            "aylik_harcama_tl": aylik_harcama_tl,
            "churn": churn,
        }
    )
Adım 2: Pipeline ile Ölçekleme, Eğitim ve Eşik Analizi
aylik_harcama_tl (150–4500) ile destek_talebi_sayisi (0–8) çok farklı ölçeklerdedir. Bu yüzden StandardScaler ve LogisticRegression adımlarını tek bir Pipeline içinde birleştiriyoruz. Böylece hem veri sızıntısını (data leakage) önlüyoruz hem de class_weight="balanced" parametresiyle azınlık sınıfı olan ayrılan müşterilere adil ağırlık veriyoruz.
def modeli_egit_ve_degerlendir(df: pd.DataFrame) -> tuple[Pipeline, dict]:
    """StandardScaler + LogisticRegression pipeline'ını eğitir ve test metriklerini döndürür."""
    ozellikler = [
        "aylik_giris_sayisi",
        "destek_talebi_sayisi",
        "uyelik_suresi_ay",
        "aylik_harcama_tl",
    ]
    X = df[ozellikler]
    y = df["churn"]

    X_train, X_test, y_train, y_test = train_test_split(
        X, y, test_size=0.2, random_state=42, stratify=y
    )

    pipeline = Pipeline(
        [
            ("scaler", StandardScaler()),
            ("classifier", LogisticRegression(class_weight="balanced", random_state=42)),
        ]
    )
    pipeline.fit(X_train, y_train)

    y_pred = pipeline.predict(X_test)
    y_proba = pipeline.predict_proba(X_test)[:, 1]

    # Eşik değeri (threshold) 0.35 karşılaştırması: daha fazla riskli müşteriyi yakalamak için
    y_pred_35 = (y_proba >= 0.35).astype(int)

    sonuclar = {
        "accuracy": float(accuracy_score(y_test, y_pred)),
        "roc_auc": float(roc_auc_score(y_test, y_proba)),
        "precision_050": float(precision_score(y_test, y_pred)),
        "recall_050": float(recall_score(y_test, y_pred)),
        "precision_035": float(precision_score(y_test, y_pred_35)),
        "recall_035": float(recall_score(y_test, y_pred_35)),
        "confusion_matrix": confusion_matrix(y_test, y_pred).tolist(),
        "report": classification_report(y_test, y_pred, target_names=["Kaldı (0)", "Ayrıldı (1)"]),
        "katsayilar": dict(
            zip(ozellikler, [float(c) for c in pipeline.named_steps["classifier"].coef_[0]])
        ),
    }
    return pipeline, sonuclar
Adım 3: Gerçek Test Çıktıları ve Metrik Yorumlama
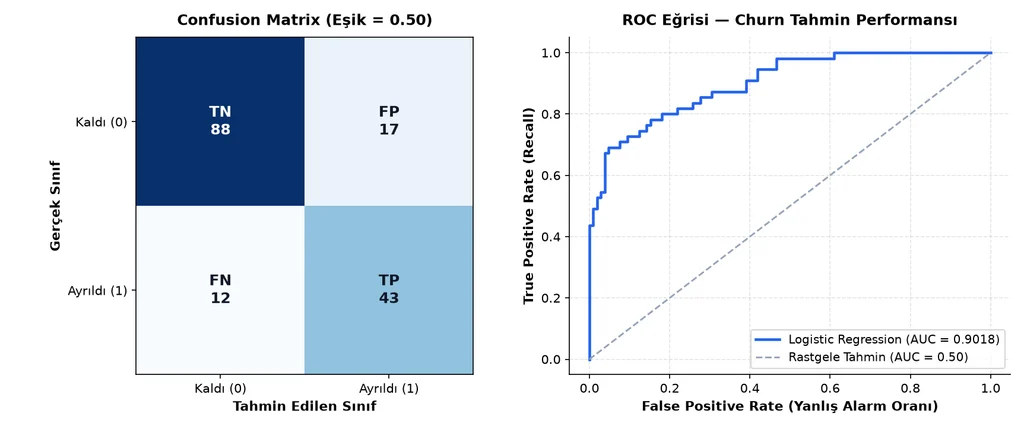
python churn_prediction.py komutunu çalıştırdığımızda elde ettiğimiz gerçek terminal çıktısı şu şekildedir:
Veri seti: 800 müşteri | Genel Churn Oranı: %34.2

--- Test Seti Performansı (Eşik = 0.50) ---
Accuracy : 0.8187
ROC-AUC  : 0.9018
Confusion Matrix ([[TN, FP], [FN, TP]]): [[88, 17], [12, 43]]

Sınıflandırma Raporu:
              precision    recall  f1-score   support

   Kaldı (0)       0.88      0.84      0.86       105
 Ayrıldı (1)       0.72      0.78      0.75        55

    accuracy                           0.82       160
   macro avg       0.80      0.81      0.80       160
weighted avg       0.82      0.82      0.82       160

--- Eşik Değeri (Threshold) Karşılaştırması ---
Eşik 0.50 -> Precision: 0.717 | Recall: 0.782
Eşik 0.35 -> Precision: 0.618 | Recall: 0.855

--- Standardize Edilmiş Katsayılar (Log-Odds Etkisi) ---
  aylik_giris_sayisi      : -1.286
  destek_talebi_sayisi    : +1.480
  uyelik_suresi_ay        : -0.436
  aylik_harcama_tl        : -0.417

--- Yeni Müşteri Churn Olasılıkları ---
Müşteri #1 -> Ayrılma Olasılığı: %98.0 (Yüksek Risk)
Müşteri #2 -> Ayrılma Olasılığı: %5.0 (Düşük Risk)
Müşteri #3 -> Ayrılma Olasılığı: %71.0 (Yüksek Risk)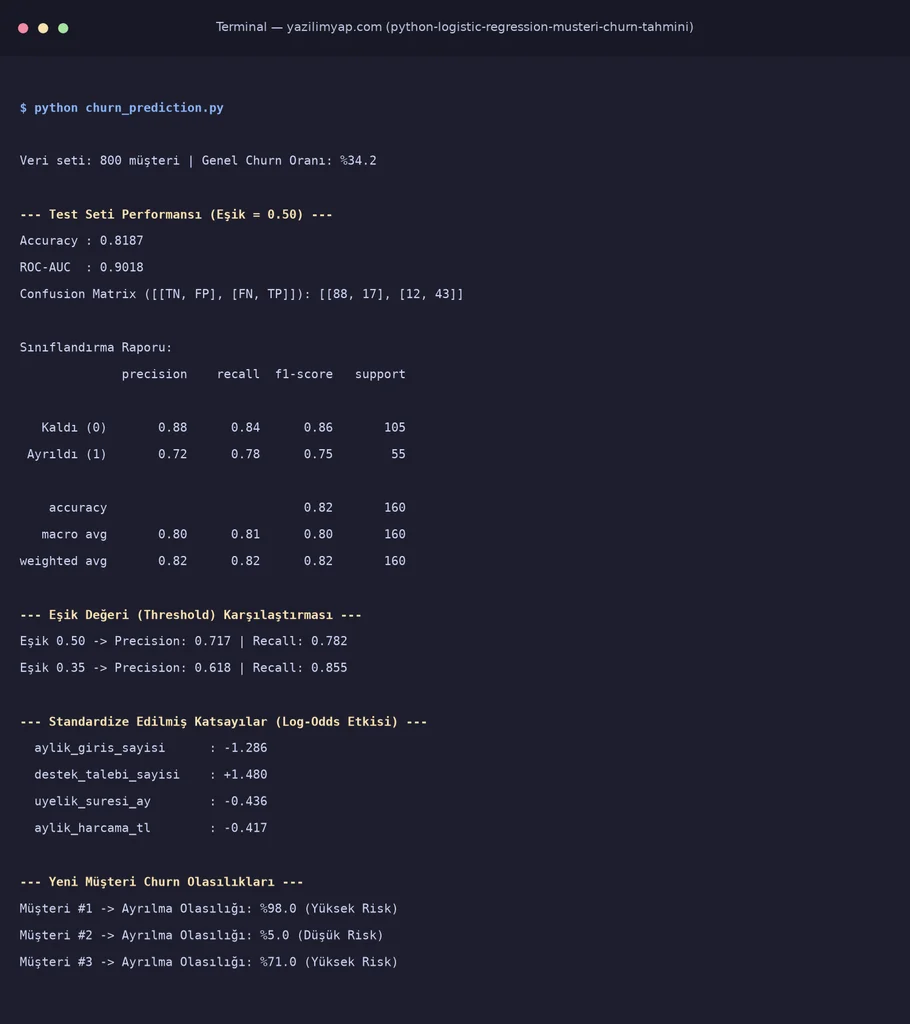
Çıktılar İş Açısından Ne Anlama Geliyor?
- ROC-AUC (0.9018): Modelin rastgele seçilen bir ayrılacak müşteriye, kalacak müşteriden daha yüksek risk puanı verme başarısı %90,18‘dir. Bu, sınıflar arası ayrım gücünün çok yüksek olduğunu gösterir.
- Confusion Matrix (
[[88, 17], [12, 43]]): Test setindeki 55 gerçek churn müşterisinin 43’ü doğru yakalandı (TP), 12’si gözden kaçtı (FN). Kalan 105 müşteriden 88’i doğru sınıflandırıldı (TN), 17’sine ise yanlış alarm verildi (FP). - Eşik Optimizasyonu (
0.50vs0.35): Eşiği0.50‘den0.35‘e düşürdüğümüzde Recall %78,2’den %85,5’e yükseldi; yani gerçekten ayrılacak müşterilerin çok daha büyük bölümünü yakaladık. Karşılığında Precision %71,7’den %61,8’e geriledi. Eğer tutundurma kampanyası (örneğin %15 indirim kuponu) maliyeti düşükse, daha yüksek Recall sağlayan0.35eşiği şirket için daha kârlıdır. - Katsayı Analizi: Standardize edilmiş katsayılara baktığımızda churn riskini en çok artıran faktörün
destek_talebi_sayisi(+1.480), en çok azaltan faktörün iseaylik_giris_sayisi(-1.286) olduğu açıkça görülüyor.
Üretim Ortamında Dikkat Edilmesi Gerekenler
Sınıflandırma Metrikleri Referans Tablosu
Confusion Matrix (Karmaşıklık Matrisi), modelin test setinde yaptığı doğru ve yanlış tahminleri dört hücrede özetler: True Positive (TP) gerçekten ayrılan ve doğru yakalanan müşterileri, False Negative (FN) ayrılacak olmasına rağmen modelin kaçırdığı müşterileri, False Positive (FP) kalacak olduğu halde yanlış alarm verilen müşterileri ve True Negative (TN) doğru biçimde kalacak olarak tahmin edilen müşterileri temsil eder.
| Metrik | Formül / Anlamı | Ne Zaman Öncelikli Olur? |
|---|---|---|
| Accuracy | (TP + TN) / Toplam — Genel doğruluk oranı | Yalnızca sınıflar dengeli dağıldığında (%50 / %50) güvenilirdir. |
| Precision | TP / (TP + FP) — “Ayrılacak” dediklerimizin kaçı gerçekten ayrıldı? | Kampanya/müdahale maliyeti çok yüksekse ve yanlış alarm istenmiyorsa. |
| Recall (Duyarlılık) | TP / (TP + FN) — Gerçekten ayrılanların kaçını yakalayabildik? | Müşteri kaybetme veya hastalık/dolandırıcılık kaçırma maliyeti yüksekse. |
| F1-Score | Precision ve Recall’un harmonik ortalaması | İki metrik arasında tek bir denge skoru gerektiğinde. |
| ROC-AUC | Tüm olası eşik değerlerindeki ayrım gücü (0.5–1.0) | Farklı modelleri eşikten bağımsız olarak kıyaslarken. |
predict_proba ile Risk Segmentasyonu ve Aksiyon Planı
Gerçek bir CRM sisteminde müşterileri sadece 0 veya 1 olarak etiketlemek yerine, musteri_risk_analizi() fonksiyonundan dönen sürekli olasılık değerlerini üç aksiyon katmanına bölmek çok daha verimlidir:
- Yüksek Risk (%60 ve üzeri): Müşteri temsilcisi tarafından proaktif arama veya kişiselleştirilmiş sadakat teklifi.
- Orta Risk (%35–%59 arası): Otomatik e-posta akışı, ürün kullanım ipuçları veya küçük indirim kuponu.
- Düşük Risk (%35 altı): Ek maliyet oluşturmadan standart iletişim akışında tutma.
Kritik Üretim Uyarıları
- Sınıf Dengesizliği (Class Imbalance): Gerçek e-ticaret verilerinde aylık churn oranı bazen %3–%5 seviyelerindedir. Bu durumda yalnızca
Accuracymetriğine bakmak sizi yanıltır;stratify=y,class_weight="balanced"ve PR-AUC / ROC-AUC metriklerini kullanın. - Doğrusal Karar Sınırı Varsayımı: Logistic Regression, özellikler ile log-odds arasında doğrusal ilişki varsayar. Karmaşık etkileşimler (örneğin hem yeni üye hem yüksek harcama yapan özel segmentler) varsa özellik mühendisliği yapın veya Decision Tree / Gradient Boosting modellerini test edin.
- Olasılık Kalibrasyonu: Eğer
predict_probaçıktılarını doğrudan beklenen gelir kaybı hesabında (olasılık × müşteri yaşam boyu değeri) kullanacaksanız,class_weight="balanced"sonrası olasılıkların kalibre edilip edilmediğiniCalibratedClassifierCVile kontrol edin.
Sıkça Sorulan Sorular (SSS)
Logistic Regression neden sınıflandırma algoritması olmasına rağmen “Regression” adını taşır?
Çünkü algoritma arka planda sınıfın olasılığının log-odds (logit) değerini doğrusal bir regresyon denklemiyle tahmin eder ve ardından bu sürekli değeri Sigmoid fonksiyonuyla 0–1 arası olasılığa dönüştürür.
Churn tahmininde Precision mı yoksa Recall mı önceliklendirilmelidir?
Çoğu churn senaryosunda Recall daha kritiktir; çünkü ayrılacak bir müşteriyi kaçırmanın maliyeti, kalacak bir müşteriye fazladan küçük bir kampanya e-postası göndermekten çok daha yüksektir.
Logistic Regression çok sınıflı (Multi-class) problemlerde kullanılabilir mi?
Evet. scikit-learn içindeki LogisticRegression, ikiden fazla sınıf bulunan hedef değişkenlerde otomatik olarak Multinomial (Softmax) yaklaşımını kullanarak her sınıf için toplamı 1 olan olasılıklar üretir.
StandardScaler kullanmadan Logistic Regression çalıştırırsam ne olur?
Modelin optimizasyon çözücüsü (L-BFGS) çok yavaş yakınsayabilir veya ConvergenceWarning verebilir. Ayrıca L2 düzenlileştirme (regularization) büyük ölçekli sütunları haksız biçimde farklı cezalandırır. Bu nedenle ölçekleme neredeyse her zaman gereklidir.
Sonuç ve Kaynaklar
Bu rehberde StandardScaler ve LogisticRegression birleşimini gerçekçi bir müşteri kaybı senaryosu üzerinde uçtan uca uyguladık, ROC-AUC = 0.9018 başarısını elde ettik ve eşik değerini değiştirmenin Precision/Recall dengesini nasıl etkilediğini gerçek çıktılarla doğruladık.
İlgili Makaleler:
- Python ile Makine Öğrenmesi Algoritmaları: 5 Temel Rehber
- Python ile Linear Regression: Ev Fiyatı Tahmini Rehberi
Kaynaklar:
Bu teknik rehber nasıldı?
Geri bildiriminiz bir sonraki içeriğin derinliğini belirler
İlgili Teknik Rehberler
Python ile Makine Öğrenmesi Algoritmaları: 5 Temel Rehber
Hiç bilmeyenler için sade anlatımla Linear Regression, Logistic Regression, Decision Tree, K-Means ve Neural Network algoritmalarını...
Python ile Linear Regression: Ev Fiyatı Tahmini Rehberi
Python ve scikit-learn ile çoklu Linear Regression kullanarak ev fiyatı tahmini yapın. Katsayı analizi, R², MAE,...
Henüz teknik bir yorum yapılmamış
Bu makaleyle ilgili ilk teknik değerlendirmeyi, soru veya katkıyı yukarıdaki alandan siz yazabilirsiniz.