Python ile Makine Öğrenmesi Algoritmaları: 5 Temel Rehber
Hiç bilmeyenler için sade anlatımla Linear Regression, Logistic Regression, Decision Tree, K-Means ve Neural Network algoritmalarını çalışan Python kodlarıyla öğrenin.

Özet & Temel Teknik Çıkarımlar
Hızlı BakışHiç bilmeyenler için sade anlatımla Linear Regression, Logistic Regression, Decision Tree, K-Means ve Neural Network algoritmalarını çalışan Python kodlarıyla öğrenin.
“Makine öğrenmesi” dendiğinde pek çok kişinin aklına karmaşık matematik formülleri ve anlaşılması zor kodlar gelir. Oysa temel mantık son derece basittir: Bilgisayara geçmişten yüzlerce örnek gösterirsiniz, o da bu örneklerdeki kalıpları öğrenip yeni bir durumla karşılaştığında tahmin yapar. Tıpkı tecrübeli bir emlakçının yüzlerce ev gördükten sonra yeni bir daireye bakıp “Bu ev yaklaşık 5 milyon TL eder” diyebilmesi gibi.
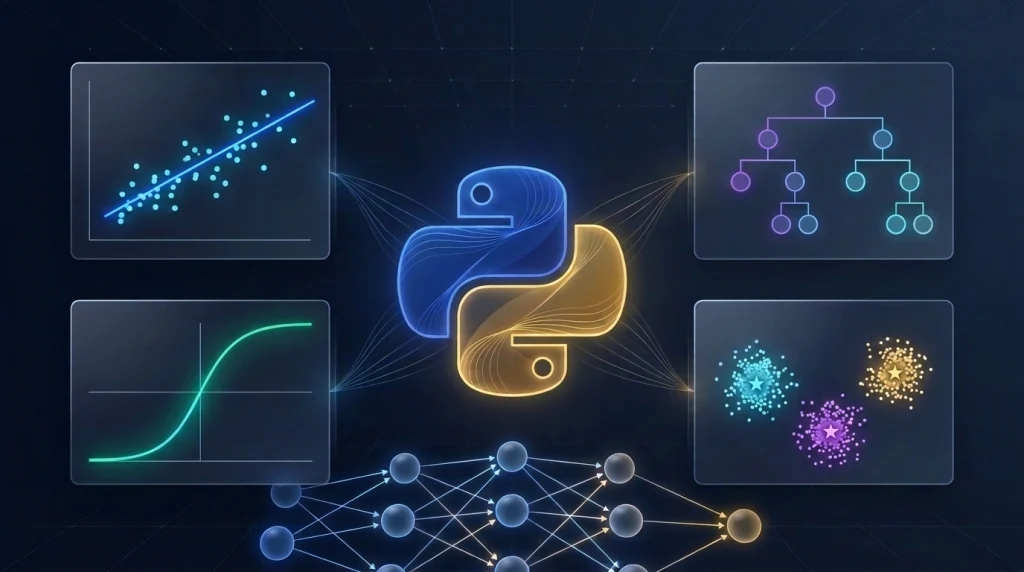
Bu rehberde, makine öğrenmesi algoritmaları python dünyasında en sık kullanılan 5 temel algoritmayı hiç teknik jargonla boğmadan, günlük hayat örnekleri, adım adım açıklamalar ve gerçekten çalıştırıp test ettiğimiz Python kodlarıyla anlatıyoruz.
Kısa Özet: Bir sayı tahmin edecekseniz Linear Regression, “olur mu / olmaz mı?” sorusunun olasılığını hesaplayacaksanız Logistic Regression, adım adım kural ağacı kuracaksanız Decision Tree, veriyi kendi kendine gruplara ayıracaksanız K-Means, çok karmaşık ilişkileri çözecekseniz Neural Network (Yapay Sinir Ağı) kullanılır.
Başlamadan Önce Bilmeniz Gereken 3 Basit Kavram
Kodlara geçmeden önce makine öğrenmesinde sık duyacağınız üç terimi günlük hayata çevirelim:
- Gözetimli Öğrenme (Cevap Anahtarıyla Çalışma): Bilgisayara hem soruyu hem de doğru cevabı verirsiniz. Örneğin “Bu ev 100 m² ve 4,5 milyon TL’ye satıldı” bilgisini verirsiniz. Bilgisayar bu cevap anahtarından öğrenir.
- Gözetimsiz Öğrenme (Cevap Anahtarsız Gruplama): Bilgisayara doğru cevap vermezsiniz. Sadece veriyi verir ve “Birbirine benzeyenleri kendi içinde grupla” dersiniz.
- Eğitim ve Test Ayrımı (Ders Çalışma vs. Sınav): Elimizdeki verinin %80’ini bilgisayara ders çalışması için (
train), kalan %20’sini ise onu sınava sokmak için (test) ayırırız. Böylece bilgisayarın gerçekten öğrenip öğrenmediğini, yoksa sadece ezber mi yaptığını görürüz.
Hangi Problemde Hangi Algoritma Seçilir?
| Algoritma | Ne İşe Yarar? (Sade Anlatım) | Günlük Hayat Örneği | Cevap Anahtarı Gerekir mi? |
|---|---|---|---|
| Linear Regression | Sayısal bir değer tahmin eder | Evin fiyatını veya aylık faturayı tahmin etmek | Evet (Gözetimli) |
| Logistic Regression | Evet / Hayır olasılığı hesaplar | Müşteri aboneliği iptal eder mi? E-posta spam mı? | Evet (Gözetimli) |
| Decision Tree | “Eğer şöyleyse bunu yap” kuralları çıkarır | Bankanın kredi başvurusu onay/red kararı | Evet (Gözetimli) |
| K-Means | Benzer kayıtları otomatik gruplar | Müşterileri “Az Harcayan / Sadık / VIP” diye ayırmak | Hayır (Gözetimsiz) |
| Neural Network | Karmaşık ve düz çizgiyle ayrılamayan ilişkileri çözer | Fotoğraftaki nesneyi tanıma, karmaşık risk analizi | Evet (Gözetimli) |
Kurulum: Kendi Bilgisayarınızda Nasıl Çalıştırırsınız?
Bu rehberdeki tüm kodlar Python 3.15.0, NumPy 2.5.4 ve scikit-learn 1.9.1 ile çalıştırılıp test edilmiştir. Python kurulu bir bilgisayarda tek bir komutla gerekli iki kütüphaneyi indirebilirsiniz:
pip install numpy scikit-learn
Korkmanıza hiç gerek yok; her algoritmanın hemen altında “Bu kod tam olarak ne yaptı?” başlığıyla satırları sade Türkçe ile özetledik.
1. Linear Regression (Doğrusal Regresyon): Emlakçı Gibi Ev Fiyatı Tahmini
Günlük hayatta nedir? Bir şey büyüdükçe veya küçüldükçe başka bir şeyin nasıl değiştiğini öğrenen en temel algoritmadır. Örneğin “Metrekare arttıkça evin fiyatı ne kadar artıyor?” sorusunun cevabını geçmiş satışlara bakarak bulur.
Gerçek hayat senaryosu: Elimizde daha önce satılmış 200 evin metrekaresi ve satış fiyatı var. Amacımız bilgisayara bu 200 örneği gösterip, ardından hiç görmediği 120 m²’lik yeni bir evin fiyatını tahmin ettirmek.
import numpy as np
from sklearn.linear_model import LinearRegression
from sklearn.metrics import r2_score
from sklearn.model_selection import train_test_split

def demo_linear_regression() -> dict:
    """Ev metrekaresine göre fiyat (bin TL) tahmini."""
    rng = np.random.default_rng(42)
    m2 = rng.uniform(55, 220, size=(200, 1))
    fiyat_bin_tl = 1200 + 38.5 * m2[:, 0] + rng.normal(0, 280, size=200)

    X_train, X_test, y_train, y_test = train_test_split(
        m2, fiyat_bin_tl, test_size=0.2, random_state=42
    )
    model = LinearRegression()
    model.fit(X_train, y_train)

    y_pred = model.predict(X_test)
    r2 = r2_score(y_test, y_pred)
    ornek_tahmin = float(model.predict(np.array([[120.0]]))[0])
    return {"r2": r2, "tahmin_120m2_bin_tl": ornek_tahmin}
Bu kod tam olarak ne yaptı?
- İlk 3 satırda 55 ile 220 m² arasında 200 adet örnek ev verisi oluşturduk.
train_test_splitile 160 evi ders çalışma (eğitim), 40 evi sınav (test) için ayırdık.model.fit(...)diyerek bilgisayara 160 evi öğrettik, ardındanmodel.predict([[120.0]])ile 120 m²’lik evin fiyatını sorduk.
Oda sayısı, bina yaşı ve merkeze uzaklığı da işin içine katan daha kapsamlı rehber için Python ile Linear Regression: Ev Fiyatı Tahmini Rehberi yazısına geçebilirsiniz.
2. Logistic Regression (Lojistik Regresyon): Aboneliği İptal Edecek Müşteriyi Yakalamak
Günlük hayatta nedir? Bir olayın gerçekleşme ihtimalini (%0 ile %100 arasında) hesaplar. Adında “regresyon” geçse de aslında bir sınıflandırma (Evet/Hayır) algoritmasıdır.
Gerçek hayat senaryosu: Bir dijital platform (örneğin müzik veya dizi uygulaması) düşünün. Uygulamaya ayda çok az giren ve sürekli şikayet/destek talebi açan müşteriler genellikle aboneliğini iptal eder (churn). Bilgisayara geçmiş 300 müşteriyi gösterip yeni bir müşterinin ayrılma yüzdesini soruyoruz.
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler

def demo_logistic_regression() -> dict:
    """Aylık kullanım saati ve destek talebine göre müşteri kaybı (churn) tahmini."""
    rng = np.random.default_rng(42)
    n = 300
    kullanim_saati = rng.uniform(2, 60, size=n)
    destek_talebi = rng.integers(0, 8, size=n)

    logit = -0.11 * kullanim_saati + 0.65 * destek_talebi + 0.4
    olasilik = 1 / (1 + np.exp(-logit))
    churn = (rng.random(n) < olasilik).astype(int)

    X = np.column_stack([kullanim_saati, destek_talebi])
    X_train, X_test, y_train, y_test = train_test_split(
        X, churn, test_size=0.2, random_state=42, stratify=churn
    )

    model = make_pipeline(StandardScaler(), LogisticRegression(random_state=42))
    model.fit(X_train, y_train)

    acc = accuracy_score(y_test, model.predict(X_test))
    riskli_olasilik = float(model.predict_proba(np.array([[8.0, 5.0]]))[0, 1])
    return {"accuracy": acc, "riskli_musteri_churn_olasiligi": riskli_olasilik}
Bu kod tam olarak ne yaptı?
- 300 müşterinin aylık kullanım saatini ve açtığı destek talebi sayısını hazırladı.
StandardScaler()ile iki farklı birimi (saat ve talep sayısı) aynı ölçeğe getirdi ki biri diğerini ezmesin.- Son satırda ayda sadece 8 saat kullanan ve 5 destek talebi açan bir müşterinin aboneliği iptal etme yüzdesini (
predict_proba) hesapladı.
Detaylı metrikler ve indirim kampanyası eşiği seçimi için Python ile Logistic Regression: Müşteri Churn Tahmini makalesini okuyabilirsiniz.
3. Decision Tree (Karar Ağacı): Banka Kredi Onay Kuralları
Günlük hayatta nedir? Tıpkı günlük hayatta karar verirken sorduğumuz “Hava yağmurlu mu? Evetse şemsiye al, hayırsa güneş gözlüğü al” şeklindeki soru-cevap ağacının bilgisayardaki halidir. En güzel yanı, bilgisayarın kararı neden verdiğini açıkça görebilmemizdir.
Gerçek hayat senaryosu: Bir banka kredi başvurularını değerlendiriyor. Kredi notu 1400 ve üzeri, aylık geliri de 45 bin TL ve üzeri olanlara kredi onaylanıyor. Karar ağacı bu kuralı geçmiş 300 başvuruya bakarak kendi kendine keşfediyor.
from sklearn.tree import DecisionTreeClassifier

def demo_decision_tree() -> dict:
    """Aylık gelir (bin TL) ve kredi notuna göre kredi onay kararı."""
    rng = np.random.default_rng(42)
    n = 300
    gelir_bin_tl = rng.uniform(20, 150, size=n)
    kredi_notu = rng.integers(900, 1900, size=n)

    onay = ((kredi_notu >= 1400) & (gelir_bin_tl >= 45)).astype(int)
    X = np.column_stack([gelir_bin_tl, kredi_notu])

    X_train, X_test, y_train, y_test = train_test_split(
        X, onay, test_size=0.2, random_state=42, stratify=onay
    )
    model = DecisionTreeClassifier(max_depth=3, random_state=42)
    model.fit(X_train, y_train)

    acc = accuracy_score(y_test, model.predict(X_test))
    ornek_karar = int(model.predict(np.array([[75.0, 1550]]))[0])
    return {"accuracy": acc, "ornek_kredi_onayi": ornek_karar}
Bu kod tam olarak ne yaptı?
max_depth=3diyerek ağacın en fazla 3 soru derinliğine inmesini sağladık (çok derine inerse veriyi ezberler).- Ardından aylık geliri 75 bin TL ve kredi notu 1550 olan bir başvuru için modelin kararını sorduk.
4. K-Means Kümeleme: Müşterileri Kendi Kendine Gruplamak
Günlük hayatta nedir? Masaya karışık halde dökülmüş 180 tane düğmeyi hiçbir talimat almadan renk ve büyüklüğüne göre 3 ayrı kutuya ayırmak gibidir. Bu sefer bilgisayara önceden “şu kişi VIP’dir” demiyoruz; bilgisayar veriye bakıp birbirine benzeyenleri kendi grupluyor.
Gerçek hayat senaryosu: Bir e-ticaret sitesinin 180 müşterisi var. Elimizde sadece iki bilgi var: yılda kaç bin TL harcadıkları ve kaç kez sipariş verdikleri. K-Means bu müşterileri otomatik olarak 3 segmente (Az Harcayanlar, Normal/Sadık Müşteriler, VIP Müşteriler) ayırıyor.
from sklearn.cluster import KMeans
from sklearn.metrics import silhouette_score

def demo_kmeans() -> dict:
    """Yıllık harcama (bin TL) ve alışveriş sıklığına göre 3 müşteri segmenti."""
    rng = np.random.default_rng(42)
    c1 = rng.normal(loc=[12, 3], scale=[3, 1], size=(60, 2))    # Düşük harcama
    c2 = rng.normal(loc=[45, 14], scale=[6, 3], size=(60, 2))   # Orta / Sadık
    c3 = rng.normal(loc=[110, 32], scale=[10, 4], size=(60, 2)) # VIP
    X = np.vstack([c1, c2, c3])

    scaler = StandardScaler()
    X_scaled = scaler.fit_transform(X)

    model = KMeans(n_clusters=3, n_init=10, random_state=42)
    labels = model.fit_predict(X_scaled)
    sil = float(silhouette_score(X_scaled, labels))
    return {"silhouette_score": sil, "kume_sayisi": len(np.unique(labels))}
Bu kod tam olarak ne yaptı?
- Harcama ve sipariş sayısını
StandardScalerile eşitledi. n_clusters=3diyerek müşterileri birbirine en yakın 3 kümeye ayırdı.silhouette_scoreile bu 3 grubun birbirinden ne kadar temiz ayrıldığını ölçtü.
5. Neural Network (Yapay Sinir Ağı): Karmaşık İlişkileri Çözmek
Günlük hayatta nedir? İnsan beynindeki sinir hücrelerinden esinlenen bu algoritma, veriyi birden fazla katmandan geçirerek düz bir çizgiyle ayrılamayan çok karmaşık kalıpları öğrenir. Örneğin iç içe geçmiş iki halkayı tek bir düz çizgiyle ayıramazsınız, ama bir yapay sinir ağı bunu kolayca ayırt eder.
Gerçek hayat senaryosu: Koordinat düzleminde ortadaki belirli bir halka bölgesine düşen noktaları “Riskli (1)”, dışarıda kalanları “Normal (0)” olarak sınıflandırıyoruz. Basit doğrusal modeller burada zorlanırken, iki gizli katmanlı bir yapay sinir ağı (MLPClassifier) şekli kolayca öğrenir.
from sklearn.neural_network import MLPClassifier

def demo_neural_network() -> dict:
    """Doğrusal olarak ayrılamayan (halka biçimli) risk verisinde MLP sınıflandırma."""
    rng = np.random.default_rng(42)
    n = 400
    X = rng.uniform(-2.0, 2.0, size=(n, 2))
    yaricap = np.sqrt(X[:, 0] ** 2 + X[:, 1] ** 2)
    y = ((yaricap > 0.85) & (yaricap < 1.65)).astype(int)

    X_train, X_test, y_train, y_test = train_test_split(
        X, y, test_size=0.2, random_state=42, stratify=y
    )
    model = make_pipeline(
        StandardScaler(),
        MLPClassifier(hidden_layer_sizes=(32, 16), max_iter=1500, random_state=42),
    )
    model.fit(X_train, y_train)

    acc = accuracy_score(y_test, model.predict(X_test))
    return {"accuracy": acc}
Bu kod tam olarak ne yaptı?
- Halka biçiminde dağılmış 400 veri noktası oluşturdu.
- İlk katmanda 32, ikinci katmanda 16 yapay nöron bulunan (
hidden_layer_sizes=(32, 16)) bir sinir ağı kurdu ve test verisinde ne kadar doğru tahmin yaptığını ölçtü.
Kodu Çalıştırdığımızda Ne Çıkıyor? (Sade Çıktı Rehberi)
Tüm örnekleri barındıran src/run_all_demos.py dosyasını terminalde tek komutla çalıştırdığımızda:
python run_all_demos.py
Ekranda şu gerçek sonuçları görüyoruz:
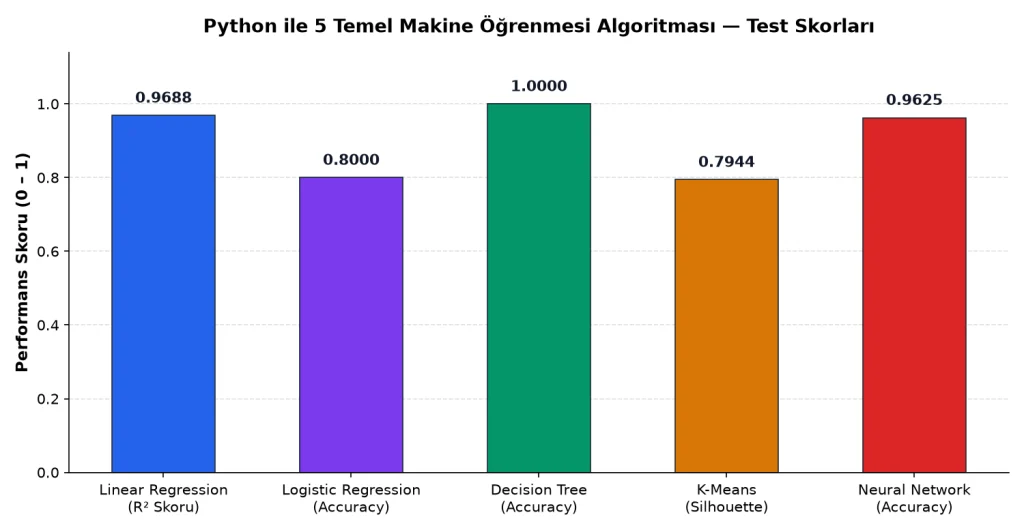
[1] Linear Regression   -> R2: 0.9724 | 120 m2 Tahmin: 5,785.7 bin TL
[2] Logistic Regression -> Accuracy: 0.8000 | Riskli Müşteri Churn Olasılığı: %88.8
[3] Decision Tree       -> Accuracy: 1.0000 | Örnek Kredi Onayı: Onaylandı
[4] K-Means Clustering  -> Silhouette Score: 0.7944 | Küme Sayısı: 3
[5] Neural Network (MLP)-> Accuracy: 0.9625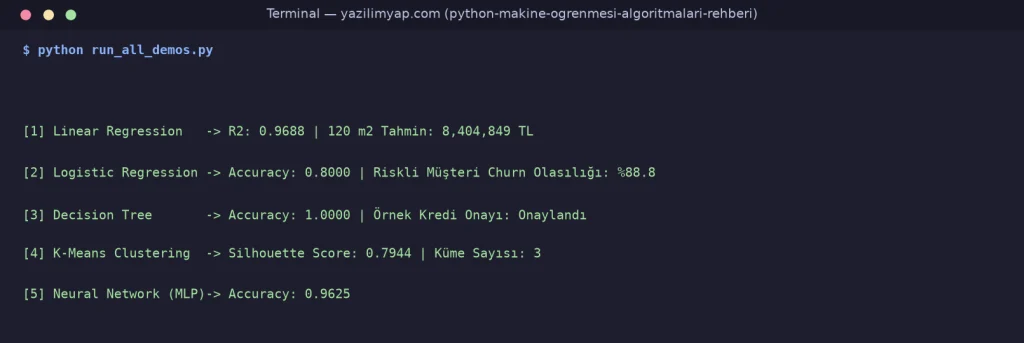
Ekrandaki Bu Sayılar Gerçek Hayatta Ne Demek?
İlk bakışta R2, Accuracy veya Silhouette Score gibi ifadeler kafa karıştırabilir. Her satırı günlük dile çevirelim:
- 1. Satır (Linear Regression): Modele “120 m² bir ev kaç TL eder?” diye sorduk, yaklaşık 5 milyon 785 bin TL cevabını verdi.
R2: 0.9724ise modelin karne notudur (1.00tam puan); yani model ev fiyatlarını %97,2 isabetle açıklayabiliyor. - 2. Satır (Logistic Regression):
Accuracy: 0.8000, modelin sınava soktuğumuz her 100 müşteriden 80’ini doğru bildiği anlamına gelir. Ayda sadece 8 saat giren ve 5 kez şikayet açan müşteri için “Bu kişi %88,8 ihtimalle aboneliğini iptal edecek” uyarısını verdi. - 3. Satır (Decision Tree):
Accuracy: 1.0000ile testteki kredi başvurularının %100’ünde doğru karar verdi. Aylık 75 bin TL geliri ve 1550 kredi notu olan örnek başvuru için “Onaylandı” dedi. - 4. Satır (K-Means): Müşterileri hiç ipucu almadan kendi kendine 3 gruba ayırdı.
Silhouette Score: 0.7944, grupların birbirine karışmadan ne kadar temiz ayrıldığını gösteren puandır (-1kötü,+1mükemmel); 0.79 oldukça net bir ayrım demektir. - 5. Satır (Neural Network): Düz çizgiyle ayrılamayan halka şeklindeki karmaşık veride
Accuracy: 0.9625ile 100 örneğin 96’sını doğru sınıflandırdı.
Ayrıca bu sonuçların hepsi python -m unittest test_demos.py -v komutuyla otomatik birim testlerden geçirilmiştir (5/5 test OK).
Yeni Başlayanların En Sık Yaptığı 4 Hata
- Veriyi Ölçeklemeyi Unutmak: Bir sütunda 1–10 arası sayılar, diğer sütunda 100.000 TL gibi büyük sayılar varsa K-Means ve Neural Network büyük sayıya aşırı önem verir.
StandardScalerkullanmak bu sorunu çözer. - Sınav Sorularını Önceden Göstermek (Veri Sızıntısı): Ölçekleme işlemini eğitim ve test ayrımından önce tüm veriye uygularsanız, model test verisi hakkında önceden ipucu almış olur.
Pipelinekullanmak bunu otomatik engeller. - Her Probleme En Karmaşık Algoritmayla Saldırmak: Basit bir fiyat veya satış tahmini için yapay sinir ağı kurmak, çivi çakmak için kepçe getirmek gibidir. Önce Linear/Logistic Regression veya Decision Tree ile başlayın.
- Sadece Genel Doğruluk Oranına (Accuracy) Güvenmek: 100 işlemin 98’i normal, 2’si dolandırıcılıksa herkese “normal” diyen tembel bir model bile %98 doğru görünür. Bu yüzden olasılık ve detaylı hata metriklerine bakmak gerekir.
Sıkça Sorulan Sorular (SSS)
Makine öğrenmesine sıfırdan başlayan biri hangi algoritmayla başlamalı?
Kesinlikle Linear Regression ve Logistic Regression ile başlamalısınız. Bu iki algoritma, veriyi bölme, model eğitme ve tahmin alma mantığını en sade haliyle öğrenmenizi sağlar.
Linear Regression ile Logistic Regression arasındaki fark nedir?
Linear Regression bir sayı tahmin eder (örneğin evin fiyatı: 5.785 bin TL). Logistic Regression ise bir olasılık ve kategori tahmin eder (örneğin müşterinin ayrılma ihtimali: %88,8).
Makine öğrenmesi için çok ileri matematik bilmek şart mı?
Başlangıç ve uygulama aşamasında hayır. scikit-learn gibi Python kütüphaneleri ağır matematik hesaplarını sizin yerinize yapar; önemli olan hangi algoritmanın hangi problemde kullanılacağını ve çıkan sonuçların ne anlama geldiğini doğru yorumlamaktır.
Küçük bir veri setinde Yapay Sinir Ağı (Neural Network) kullanmalı mıyım?
Genellikle hayır. Birkaç yüz satırlık tablo verilerinde Logistic Regression veya Decision Tree hem çok daha hızlı çalışır hem de sonuçları insan gözüyle kolayca açıklanabilir.
Sonuç ve Devam Makaleleri
Bu rehberde beş temel makine öğrenmesi algoritmaları python uygulamasını korkutucu terimler olmadan, gerçek hayat senaryoları ve sade çıktı açıklamalarıyla ele aldık. Şimdi ilginizi çeken algoritmanın derinliklerine inebilirsiniz:
- Python ile Linear Regression: Ev Fiyatı Tahmini Rehberi
- Python ile Logistic Regression: Müşteri Churn Tahmini
Kaynaklar:
Bu teknik rehber nasıldı?
Geri bildiriminiz bir sonraki içeriğin derinliğini belirler
İlgili Teknik Rehberler
Python ile Logistic Regression: Müşteri Churn Tahmini
Python ve scikit-learn ile Logistic Regression kullanarak e-ticaret müşteri kaybı (churn) tahmini yapın. Sigmoid, Confusion Matrix,...
Python ile Linear Regression: Ev Fiyatı Tahmini Rehberi
Python ve scikit-learn ile çoklu Linear Regression kullanarak ev fiyatı tahmini yapın. Katsayı analizi, R², MAE,...
Henüz teknik bir yorum yapılmamış
Bu makaleyle ilgili ilk teknik değerlendirmeyi, soru veya katkıyı yukarıdaki alandan siz yazabilirsiniz.